
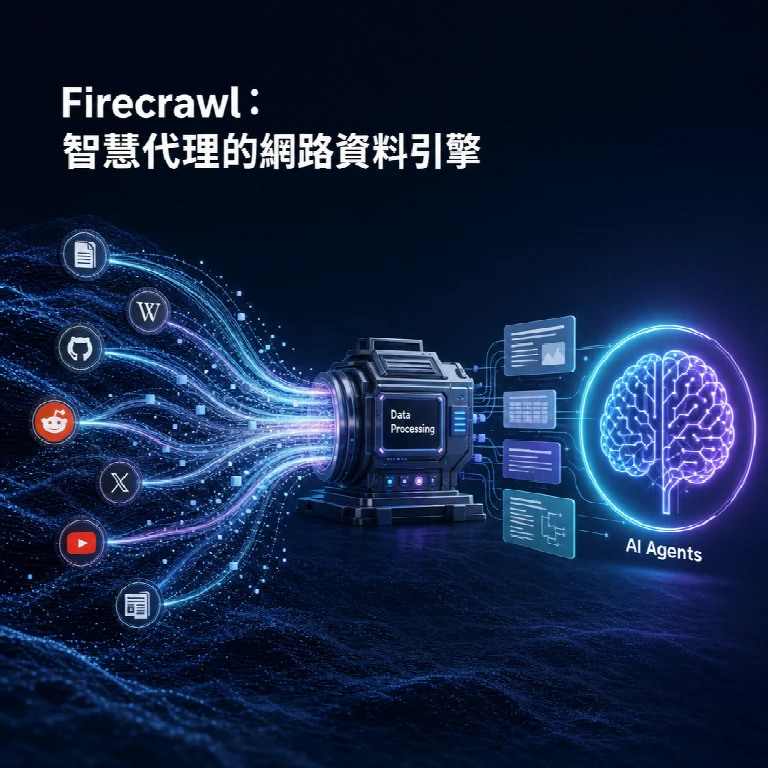
在數位化浪潮與人工智慧(AI)技術日新月異的今天,從廣闊的網路世界中高效、精準地獲取資訊,並將其轉化為可供機器學習模型或智慧型代理(AI Agent)理解與運用,已成為眾多開發者與企業面臨的核心挑戰。一個名為 firecrawl/firecrawl 的開源專案,正試圖針對此一需求提供一套全面性的解決方案。截至 2026 年 9 月,該專案在 GitHub 上累積了高達 180686 顆星,並擁有 9803 個分叉,顯示其在技術社群中受到廣泛關注。
此專案以 TypeScript 語言開發,涵蓋了人工智慧、AI 代理、AI 爬蟲、AI 抓取、AI 搜尋、爬蟲、資料擷取、HTML 轉 Markdown、大型語言模型(LLM)、Markdown、抓取工具、網路爬蟲、網路資料、網路資料擷取、網路抓取工具以及網路搜尋等諸多技術主題。它不僅是一個網路爬取工具,更是一個專為大規模網路資料搜尋、抓取及互動而設計的上下文應用程式介面(API),旨在為智慧型代理提供可靠的資料來源,並將擷取到的內容轉化為乾淨的 Markdown 格式或結構化資料,以利於代理直接應用。該專案遵循 AGPL-3.0 授權條款開放,其最後一次更新紀錄為 2026 年 9 月 15 日。
Firecrawl 的核心價值與解決方案
Firecrawl 旨在解決傳統網路爬取面臨的諸多痛點,特別是針對需要大量且高品質網路內容以訓練或運行大型語言模型的開發者與研究人員。其核心價值體現在以下幾個關鍵層面:
1. 無與倫比的網路覆蓋率與可靠性
傳統的網路爬蟲常會遇到 JavaScript 渲染頁面、反爬機制、代理伺服器管理等複雜問題。Firecrawl 強調其具備業界領先的可靠性,宣稱能夠覆蓋高達 96% 的網路內容,甚至包括那些高度依賴 JavaScript 才能完整顯示的頁面。這意味著開發者無需再為代理伺服器設定、封鎖、或者 JavaScript 渲染的處理而傷腦筋,即可獲得穩定且高品質的資料。根據其官方提供的基準測試數據,這項能力是其區別於其他爬取工具的重要優勢。
2. 極致的資料擷取速度
在即時應用和動態系統中,資料擷取的速度是決定效能的關鍵因素。Firecrawl 專案號稱具備「閃電般」的速度,在數百萬頁面的爬取測試中,其 P95 延遲僅為 3.4 秒。這項性能指標顯示,Firecrawl 能夠滿足需要即時資料回應的智慧型代理或動態應用程式的需求,避免因資料獲取延遲而導致的效能瓶頸。
3. 大型語言模型友善的輸出格式
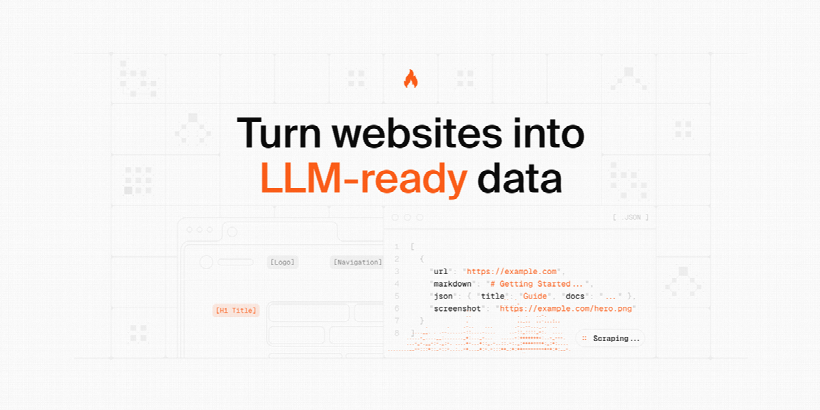
專案的一大亮點是其能夠產生「大型語言模型(LLM)就緒」的輸出內容。透過將擷取到的網頁內容轉換為乾淨的 Markdown 格式或結構化 JSON 資料,甚至提供頁面截圖,Firecrawl 大幅降低了開發者處理原始 HTML 內容的工作負擔。對於大型語言模型而言,接收結構清晰、無雜訊的輸入資料,不僅能提高處理效率,更能減少不必要的計算資源消耗(Tokens),進而提升 AI 應用程式的品質與精準度。這讓開發者可以將更多精力放在模型訓練與應用邏輯上,而不是資料清洗。
4. 自動化處理複雜爬取挑戰
網路爬取從來不是一件簡單的事。旋轉代理、任務協調、應對速率限制、處理被 JavaScript 阻擋的內容等等,這些都是開發者在進行大規模爬取時必須面對的「硬仗」。Firecrawl 宣稱能夠自動處理這些複雜的底層技術細節,提供「零配置」的便利性。這意味著使用者可以專注於定義需要擷取的內容,而無需深入配置繁瑣的網路請求與繞過機制,大大降低了使用的門檻和開發成本。
5. 高度整合智慧型代理工作流程
Firecrawl 的設計宗旨之一就是作為智慧型代理的「上下文 API」。它提供了便捷的方式,讓任何 AI 代理或多核心處理器(MCP)客戶端能夠輕鬆連接並利用 Firecrawl 提供的資料。這種設計理念使得 Firecrawl 成為構建智慧型自動化系統的理想選擇,代理可以透過它獲取最新的網路資訊,進而執行搜尋、分析、互動等更為複雜的任務。
6. 多媒體內容解析能力
除了文字內容,Firecrawl 還具備解析並從網路託管的 PDF、DOCX 等多媒體文件中提取內容的能力。這項功能擴展了其資料來源的範圍,讓智慧型代理能夠從更多元的檔案格式中獲取所需的資訊,增強了其處理各種網路資源的能力。
7. 支援網頁互動動作
Firecrawl 不僅僅是靜態資料的抓取者,它還支援一系列的網頁互動動作。這包括點擊(Click)、滾動(Scroll)、寫入(Write)、等待(Wait)以及按壓(Press)等操作,然後再進行內容擷取。這使得 Firecrawl 能夠模擬用戶在網頁上的行為,訪問需要互動才能揭示的內容,或是執行特定動作後才能獲取的資訊,進一步提升了其在動態網頁環境中的實用性與靈活性。
8. 開源與社群驅動
Firecrawl 作為一個開源專案,其開發過程是透明且協作的。這種模式有助於吸引廣大的開發者社群參與貢獻、提出改進意見,並共同解決問題。透過社群的力量,專案能夠持續迭代、優化,並應對不斷變化的網路環境,確保其技術領先性與實用性。專案也鼓勵使用者加入其 Discord 社群進行交流與協作。
Firecrawl 的應用場景與潛力
基於上述特性,Firecrawl 在多個領域展現了廣闊的應用前景:
- 智慧型搜尋與知識庫建構:企業可以利用 Firecrawl 大規模抓取特定領域的網路內容,建立專屬的知識庫,為內部員工或客戶提供更精準的資訊檢索服務。
- 競爭情報分析:透過定期爬取競爭對手的網站、產品頁面、新聞稿等資訊,企業可以即時掌握市場動態,為戰略決策提供數據支持。
- 大型語言模型資料集建構:研究人員和開發者可以利用 Firecrawl 快速且高效地蒐集大量高品質的網路文本資料,用於訓練和微調大型語言模型,提升模型的語言理解與生成能力。
- 自動化內容生成與策展:結合智慧型代理,Firecrawl 可以自動抓取相關內容,並將其整理成 Markdown 或結構化資料,進而用於自動生成報告、文章摘要或社群媒體內容。
- 輿情監測與品牌聲譽管理:透過監測網路上的相關討論、新聞報導與用戶評論,企業可以即時了解公眾對其產品或品牌的看法,及早應對潛在的危機或抓住新的機會。
- 產品價格監測與市場趨勢分析:電商平台或零售商可以利用 Firecrawl 定期爬取競品價格,分析市場趨勢,以便調整自身定價策略。
- 學術研究與資料收集:學者可以利用 Firecrawl 獲取特定主題的大量網路文獻,作為研究資料來源,加速研究進程。
如何快速上手與使用
雖然具體的使用細節(如 API 接口、參數設定等)不在本次來源資料中詳細闡述,但從其「上下文 API」與「代理就緒」的描述來看, Firecrawl 應當提供易於整合的 API 接口,讓開發者能夠透過程式碼調用其功能。其目標是讓使用者能夠專注於定義資料需求,而由 Firecrawl 來處理所有複雜的爬取與資料整理工作。
由於專案採用了 TypeScript 進行開發,這表示對於前端與後端採用 JavaScript 生態系的開發者而言,學習與整合的門檻可能相對較低。同時,其強調的「零配置」特性,也預示著使用者將能夠以較少的設定步驟,便能快速啟動資料抓取任務。
值得注意的是,Firecrawl 提供開源版本,同時也提供一個託管服務。這意味著小型開發者和個人使用者可以選擇自行部署開源版本,而對於需要更高可用性、擴展性和維護服務的企業用戶,則可以考慮使用其託管服務,從而降低營運負擔。
授權與注意事項
Firecrawl 專案採用 AGPL-3.0 授權條款。AGPL(GNU Affero General Public License)是一種具有強傳染性的開源授權協議。簡而言之,如果開發者在自己的應用程式中使用了 AGPL 授權的軟體並透過網路提供服務,那麼開發者有義務公開其應用程式的原始碼。這對於計畫將 Firecrawl 整合進商業服務的開發者而言,是一個需要仔細評估的方面。在使用此專案時,務必詳細閱讀並理解該授權條款,以確保合規性。
此外,儘管 Firecrawl 聲稱具備高可靠性與廣泛的網路覆蓋,但在實際應用中,仍需考慮網路爬取的道德與法律規範。網站的服務條款、機器人排除協議(robots.txt)以及各地區的資料保護法規(例如 GDPR、臺灣個人資料保護法等)都是在進行網路資料擷取時不可忽視的因素。合法、合規地使用任何爬取工具,是每位開發者的基本責任。
總結來說,firecrawl/firecrawl 專案提供了一個強大且高效的解決方案,旨在簡化大規模網路資料的擷取與處理過程,特別是為智慧型代理與大型語言模型提供乾淨、結構化的上下文資料。它透過解決傳統爬取工具的痛點,並提供一系列創新的功能,使其成為當前人工智慧應用開發領域中一個值得關注的開源專案。